笔记
ACES 量子真机食用
ACES 量子真机食用
真机情况
杭州的真机不了解,是阿里捐的。宁波目前有三台制冷机for超导量子芯片。下面提到的内容是关于宁波的真机。
文档定位
这个文档的内容是从一个量子相关的项目总结出来的。文档内容包括,量子计算的一些基础知识、上真机需要了解的背景。第二部分是一些零碎的知识点。
文档有些内容没有详细介绍,只提供一个引出的作用。
以后给量子项目打工的同学(希望不要有了),这篇文档可以提供一些帮助。
量子电路的组成
量子线路的组成
线路组成
1 Classical Input 经典输入
在进入量子线路前,此时是经典数据。对经典数据根据自己的要求,先进行预处理(比如归一化到某些角度方便后面做映射、构造一些符合物理约束的变量等等)。这一步是纯经典计算。
2 State Preparation / Data Encoding
这两部分不太一样,但是很多时候混在一起,后者可以看作是前者的一部分。
前者是状态制备(有很多叫法),硬件上所有的量子比特默认初始状态都是,这一步是把初始状态变成算法输入需要的量子态。
Data Encoding :把经典信息注入量子态。这样讲有点抽象。我是这么理解的,经典数据我们用矩阵保存,矩阵每一个元素是数字,这些数字保存了信息。但是进入量子领域,信息就得用量子世界的格式保存:量子比特靠相位、概率振幅保存信息。所以数据编码其实就是把信息从一种格式(浮点数)映射到另一种格式(相位、概率振幅)。
那么这两个步骤有什么联系呢?比如:
把初态 制备到算法需要的状态:
从初态得到最后的输入态,经过了两个阶段。
第一段的量子门跟输入数据没有关系;第二段加的量子门,门的旋转角度是经典数据决定的,这些门就是Data Encoding 得到的。
整个过程(两个阶段)都属于State Preparation。
数据编码有角度编码、振幅编码等很多方法。
3 Parameterized Ansatz 参数化拟设
这一部分先把他叫做黑盒。制备的量子态,进入这个黑盒,得到最终的量子态。
黑盒由量子门组成的,量子门包含可以训练的参数(量子门旋转角度、就像神经网络的参数一样)。(注意,Data Encoding 中量子门的角度是经典数据决定的,经典数据变,角度才会变。Ansatz 里面的角度,在训练过程中是不断变化的,优化器根据梯度更新。)
Ansatz 怎么设计方法很多:Hardware-efficient Ansatz、UCCSD、Adaptive Ansatz…
(关于 Ansatz 的论文我一篇没看过,从哪些角度考虑,有哪些 trick 我也狗屁不会。那这个项目最后的线路是怎么设计的呢:在要烂尾的时候,老师找来了做量子算法的博士师兄,现场讨论一小时给出方案,最后完全按照师兄的方法做的)
另外,量子参数求梯度,没法用PyTorch 的反向自动微分,因为整个过程不是完全可微,只能用量子的 Parameter-shift。 此外,还会遇到 Barren Plateau 问题。
4 Measurement
测量。
经过 Ansatz 之后得到需要的量子态,执行测量。真机给出的是 bitstring。
-
测量的理解
对量子态执行测量操作,需要先选定基底。
测量操作更容易理解的名字应该叫投影:把量子态投影到选定的基底上,得到观测结果。
另一种理解:测量是只能沿着选定的轴 观测该量子比特(量子态由若干个量子比特组成)的信息。比如,一个量子比特在三维空间中可以指向任意方向。沿着 Z 基观测,只能看到量子比特朝上或者朝下的信息。但是量子比特也可以朝前朝后,朝左朝右,这时候需要选定别的基观测;
-
观测结果是什么?
确定基底(假设是泡利 Z 矩阵)后,任意一个量子态都可以表示成基底对应的本征态的线性组合;
测量操作会让这个量子态(此时是叠加态)坍缩到其中一个本征态;
一个量子比特,有两种本征态: or ;三个量子比特构成的量子态:有 种本征态;
-
不同基底的测量结果
选定 Z 基,坍缩到 or ;
选定 X 基,坍缩到 or ;
选定 Y 基,坍缩到 or ;
其中:
-
真实量子计算机只能执行 Z 基测量。如果想做 X 基测量,在测量前加一个哈达玛门 Hadamard 。
-
真实的测量结果:以一个 3 比特电路为例
真机返回的测量结果:bitstring 的概率。
 P(000)= 0.235666666667,
 P(001)= 0.071,
 P(010)= 0.198333333333,
 P(011)= 0.0516666666667,
 P(100)= 0.158666666667,
 P(101)= 0.133333333333,
 P(110)= 0.0786666666667,
 P(111)= 0.0726666666667,
如果是在 Z 基测量:P(010) 就代表测量得到本征态 的概率;
在 X 基测量:P(010) 就代表测量得到本征态 的概率;
真实硬件执行一次电路、一次测量只能得到这个量子态8 种情况中的一种,反复采样得到每个本征态出现的次数,然后除以总采样次数得到概率。
-
得到本征态之后,根据算法目的,进行后面的处理。
需要了解的真机信息
一些背景:
量子比特是需要准备的。 对于超导量子计算机,那些刻在硅片上的电路(量子比特),不是开机就能用,需要经过硬件同学的校准。校准好了也不行,那些参数受环境影响还会变化。所以需要硬件同学反复地监测、重新校准。有一次真机同学调好了比特,打算吃完饭回来给我们用,结果一顿饭的功夫,比特漂移了;还有更夸张的,硬件同学花几天准备工作做了一大堆,结果宁波鄞州区停几秒钟电,所有工作从零开始。
真机资源比较宝贵。 大概 20 比特的电路,训练出来得 2 个月时间。这个项目的单分子方案,上真机的电路只有 3 比特,数据集 800 个分子构型,训练一个 epoch 得 4 小时左右。我记得调出五六十个能用的比特,在我们这里可能得两三个月的时间。(时间都只是个大概,不是一定准确,但确实耗时)
噪声指标
真机是有噪声的:
-
一般是先在无噪条件下跑。这一步没有噪声影响,主要看算法设计本身是否有问题;
-
然后用 Qiskit 的模拟器(比如 AerSimulator)建立噪声模型,做含噪模拟。这一步用来看模型对噪声的鲁棒性,指导模型可能的改进方向,让电路更抗噪;
-
最后在真机上跑。
(这个项目最终用了预训练+微调)
需要知道硬件的以下指标:
每个量子比特的 T1 、T2
T1 T2 : 简单理解是量子比特存储信息的时间是有限的,超过这个时间,量子比特的信息就不准确了。所以电路深度不能设计太深,不然电路还没跑完,量子比特信息都丢失了,最终测量结果和理想线路的偏差会很大。
(我们三个比特 T1 分别是 45us/42us/40us ;T2 是 1.5us/1.9us/0.7us ;26 年一篇文章提到,世界上最好的超导量子比特记录 T2=1.5ms;领先了 3 个数量级.)
每个量子比特的读取保真度
把 1 读成 1 、0 读成 0 的概率。
我们的三个比特读取保真度:0.85 / 0.82 / 0.81
量子门的保真度
这个保真度是操作层面:对一个量子比特施加量子门,得到我们希望的效果;但是有概率不是我们期望的效果。比如 X 门翻转一个量子比特的状态;从 0 到 1;有 98% 的可能,对量子比特施加 X 门之后它变成了 1,但是有 2% 它还是0 态;比如双比特纠缠门,98% 概率两个量子比特完美纠缠,但是 2% 概率纠缠不够深;
单比特门:0.9984 / 0.9982 / 0.9983;
双比特门:0.98(Q1 和 Q2) 0.98(Q2 和 Q3)
世界最好记录:单 99.99% 双 99.9%
设计量子线路时,尽可能用真机保真度高的门。
量子门执行时长
门时长:单比特40ns,CZ60ns,RZ 0ns(VZ门)
(如果 RZ 支持虚拟会更好)
真机友好的门
真机有很多流派,不同硬件的原生门不一样。宁波真机是谷歌路线,此外还有 IBM 的传统路线等等。
-
宁波真机硬件友好门:RX,RZ,CZ,X,SX。
RZ 门尤其容易实现且RZ 可以虚拟;
双比特门以 CZ 为主,不要加参数,把旋转角放在单比特门上;
单比特门 RX RZ 支持任何角度,角度最好不要在 0 附近;在±二分之π或者π附近最好;角度没有其他限制,可以小数。
角度需要编译,真机支持两种实现方式,通过调脉冲实现 or 被分解为若干门(通过若干门组合,凑出任意角度);
如果打算上真机,设计量子线路最好用真机友好的门。
其他信息
量子比特的拓扑结构
设计逻辑线路时,可以让任意两个比特产生纠缠,比如 Q1 和 Q999;但是生成在真机上执行的量子电路,需要让它满足拓扑约束:只有硬件上相邻的 qubit 才允许直接 CZ。
直白讲,有两种做法:
1 不考虑你要用的真实量子比特的位置,按照自己的算法在任意量子比特之间加纠缠门,在编译时才加入拓扑约束,Qiskit 会通过引入 SWAP 门,使你的线路满足硬件要求。但是天下没有免费的午餐,SWAP是双比特门,带来的噪声副作用比单比特门大很多,当电路大量存在 SWAP ,电路效果不会好。
2 设计电路时就考虑拓扑约束,但加门的位置就受到限制。
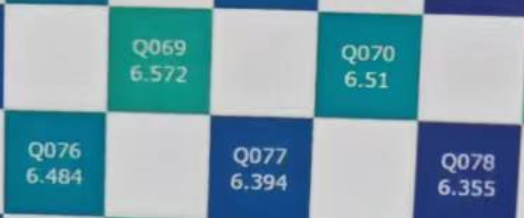
如图,Q69 和 Q76 挨着,可以直接加 CZ;但 Q69 没法和 Q78 直接 CZ。这个时候就要引入 SWAP 门,离得越远,SWAP 门越多。
电路深度
Transpile 之后的电路深度不能太深。
算法设计层面,电路深度也许看着不深,但这只是 Logical circuit depth。Transpile 之后的 depth 才是真机要跑的深度。前面提到,逻辑门不一定等于真机原生门,电路先Transpile 成原生门之后才能在真机上跑,这个过程可能会引入 SWAP、routing 等等导致线路深度变大。
量子电路操作必须快:深度 乘以 门时间 必须 小于 T2 ;否则量子信息全部丢失,全是噪音。
深度太大:电路执行时间变长,T1 T2 时间就那么点,最后结果偏差肯定大;门错误会累计,一个 CZ 的保真度 0.999,看起来还不错;但100个 CZ 只剩下 0.905;
采样次数 shots
一个 shot 是指初始化一次量子电路、执行一次门序列,得到一个 bitstring 的过程。shot 越多,统计误差越小。
耦合
逻辑上经常说量子门,但物理上是不存在有这么一个能直接加上去的门。我们希望量子比特完成某种效果,是通过脉冲、调频实现的。不断调这些东西,让量子态按照我们希望的方式演化。
-
耦合:是指两个量子比特之间的相互作用,实现纠缠门的手段。
耦合强度:两个量子比特之间的耦合强度,不仅取决于物理连接,还取决于他们之间的频率差。
频率越相近,越容易发生能量交换。
耦合有好有坏:
-
想要的耦合:
直接耦合:量子比特直接通过电容、电感等产生相互作用; 间接耦合:用一个可调耦合器 (一个电路)专门控制两个比特之间的耦合强度;
-
不想要的耦合:
硬件上,两个量子比特靠的近,此时我们对其中一个施加量子门,另一个比特也会被轻微带偏,就产生了误差。 这也是超导量子芯片的问题之一,叫做串扰(Crosstalk)。 解决方法:可以调频,让两个比特的频率不同;用可调耦合器把不想要的耦合抵消掉;
弱耦合可以近似为关断(认为他们没有相互作用);
总结
上真机时,问清楚各个噪声指标的值、门的保真度;问清楚自己能用的量子比特的拓扑关系;问清楚真机能接受的电路深度;
得到量子线路图
先介绍一下三种对象
QuantumCircuit、QPY、QASM
-
QuantumCircuit:存在于内存中
Qiskit 的 QuantumCircuit 类,是电路对象。Qiskit 会把逻辑上设计的量子比特、门的顺序、连接规则等组装成 QuantumCircuit对象。可以根据这个对象画出电路图:
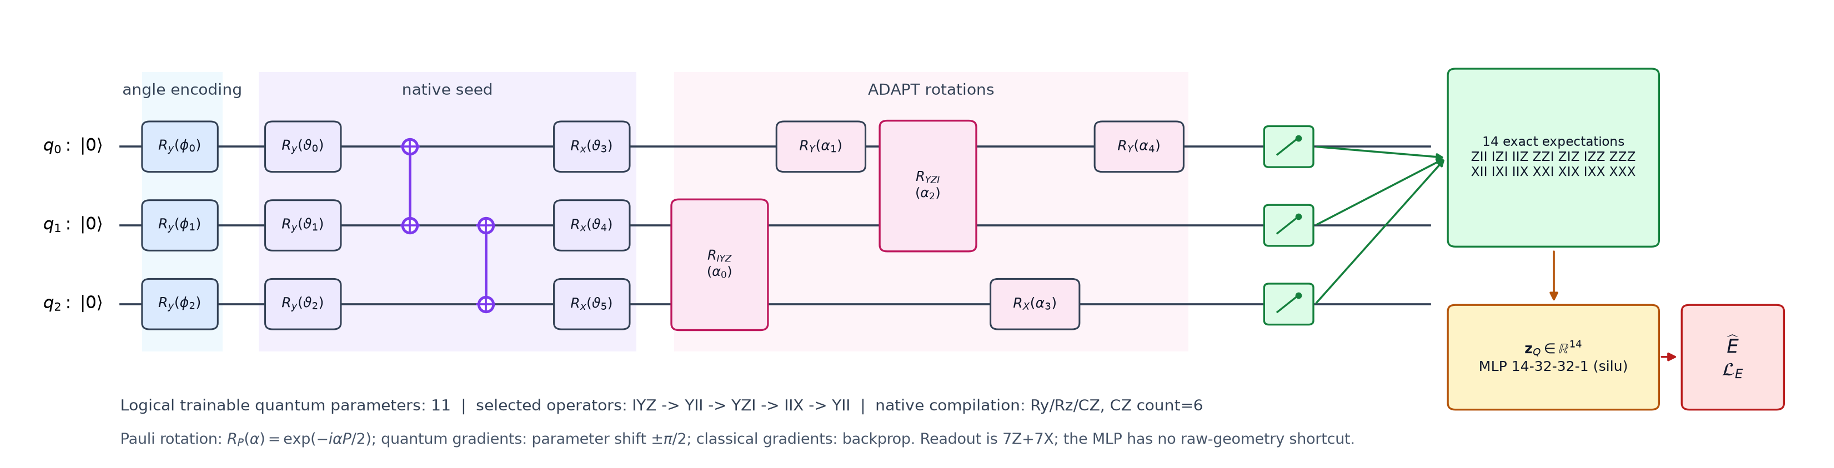
但这个只是算法层面的,真机同学关心的是原生门组成的电路。
-
QPY
QPY是二进制文件,像是把 QuantumCircuit 原样打包保存;在 Qiskit 中完整存取这些电路,用 QPY;
对 QuantumCircuit 对象 qpy.dump 之后可以得到 QPY 文件;
-
QASM
qasm 是人可读的 量子汇编语言。文本文件。描述了门、比特和测量等操作。方便在不同平台传递(我们和真机传递的电路就是以这种格式);
对 QuantumCircuit 对象qasm3.dump 之后得到 QASM 文件;
下面展示怎么得到编译之后的电路图
-
先导入必要的包
from pathlib import Path from qiskit import qpy from qiskit import transpile ...... -
加载 由QuantumCircuit 生成的 QPY 文件
qpy_path = "logical_parameterized_circuits.qpy" with qpy_path.open("rb") as handle: circuits = qpy.load(handle) # Circuits是一个电路列表 #这里有三个电路分别是:不带测量门、带测量门Z、带测量门 X state_preparation_circuit = circuits[0] z_measurement_circuit = circuits[1] x_measurement_circuit = circuits[2] -
画出电路图
''' circuits[0].draw("mpl") 得到上面的circuits[0]可以直接draw 出来,更好的是Transpile 成原生门再画; ''' qc = transpile( circuits[0], basis_gates=["rx", "rz", "cz"], coupling_map=[[0, 1], [1, 0], [1, 2], [2, 1]], optimization_level=3, seed_transpiler=0, ) qc.draw("mpl")circuits[0]是待编译原始电路;basis_gates就是真机的原生门,问负责硬件的同学;coupling_map拓扑约束,表示Q0和Q1允许直接两比特门;Q1和 Q2 允许直接两比特门;如果 Q0 和 Q2 有纠缠,就要加入 SWAP 门;optimization_level编译电路时的优化级别:4 档:0,1,2,3;级别越高,编译时间越久,但门数、电路深度和拓扑路由开销也会变少; 一般为了方便真机执行,opt 要开到 3; -
得到用于评估电路代价的图:
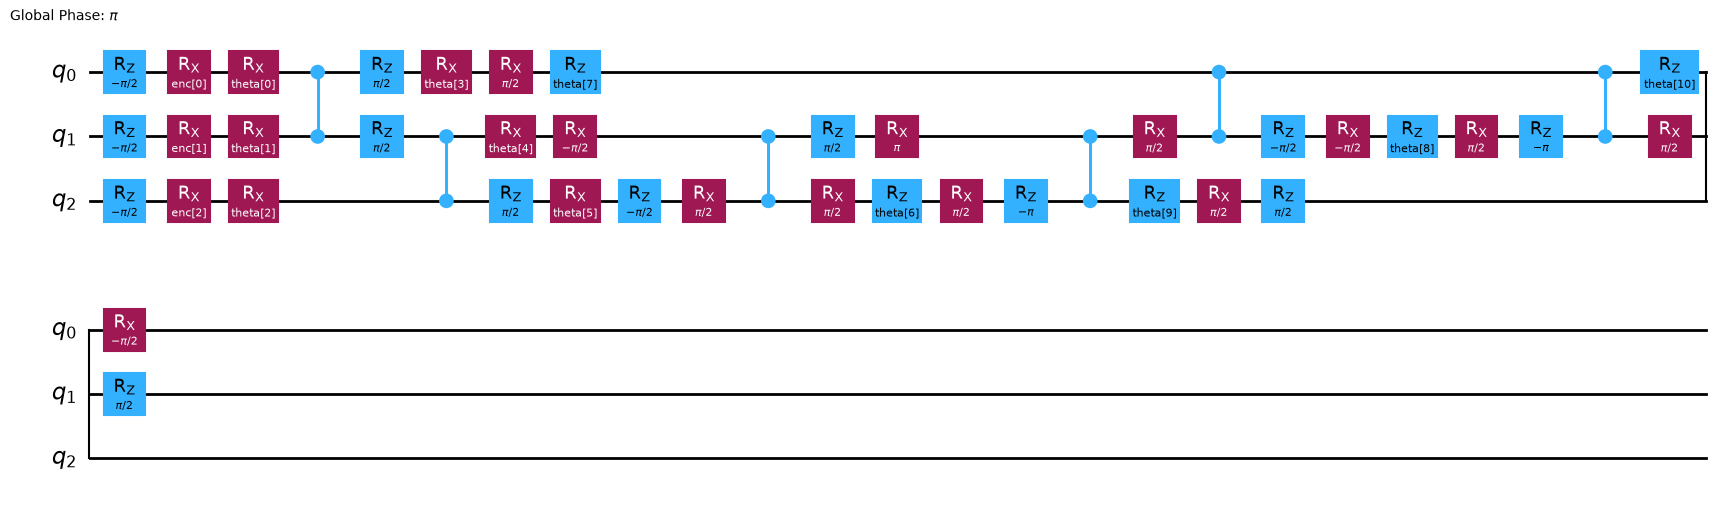
和真机交互
和纯本地模拟差别不大,就是多了一个接口,把准备好的电路通过接口发给真机,真机运行完再返回测量结果。(真机跑的过程咱也看不懂,对于我们完全是一个黑盒,唯一的用处也许是吹牛?我写的代码在量子计算机上跑了!哇真爽😁!真的爽吗?)
下面讲一下我们这个项目和真机是怎么交互的。
真机只做两件事
- 接受 QASM3 文件,执行电路;
- 返回包含所有 bitstring 概率的 JSON 文件;
HTTP 接口
真机连接着测控电脑,我们不是直接和真机交互,是和测控电脑交互。测控电脑负责给真机提交任务。
测控电脑作为服务端,我们的电脑是客户端,两边实现了 HTTP 接口。
- 整个程序在我们电脑上跑,需要跑量子线路时,程序把编译后的电路导出为 QASM3 文本文件,通过 HTTP 接口上传(一块上传的还有 shots、measure_base);
(服务端拿到我们上传的文件,可能两边会做一下校验相关工作,这不是重点)
- 真机把跑完的电路结果,返回给我们一个 JSON 文件。
上传的 QASM 文件
大致长这样:
OPENQASM 3.0;
include "stdgates.inc";
qubit[3] q;
ry(0.656266404163457) q[0];
ry(1.280696559581763) q[1];
ry(0.8050340330913022) q[2];
cz q[0], q[1];
真实提交的也不是这样一个文件,是把 QASM3 文本作为 HTTP 字段发送。
返回的 JSON
部分 JSON 内容;
{
  "circuits": [
    {
      "circuit_id": "quantum-predict-geometry-33c2dc0c2a3c4213814342609af360c5.000080.X",
      "filename": "circuit-000161.qasm",
      "measurement_basis": "X",
      "sha256": "8a795b56fec7d3cedc7955abf347782194344ccc067d5e674c1463e91938dc4a"
    }
  ],
  "response": {
    "job_id": "2e2792c3-ab71-4e4a-8662-dd7bdf9d89ad",
    "status": "succeeded",
    "files": [
      {
        "name": "circuit-000161.qasm",
        "index": 1,
        "bytes": 712,
        "sha256": "8a795b56fec7d3cedc7955abf347782194344ccc067d5e674c1463e91938dc4a"
      }
    ],
    "result": {
      "columns": [
        "circuit",
        "expr_prob_P000", "expr_prob_P001", "expr_prob_P010", "expr_prob_P011",
        "expr_prob_P100", "expr_prob_P101", "expr_prob_P110", "expr_prob_P111",
        "ideal_prob_P000", "ideal_prob_P001", "ideal_prob_P010", "ideal_prob_P011",
        "ideal_prob_P100", "ideal_prob_P101", "ideal_prob_P110", "ideal_prob_P111"
      ],
      "data": [
        [
          1.0,
          0.235666666667, 0.071, 0.198333333333, 0.0516666666667,
          0.158666666667, 0.133333333333, 0.0786666666667, 0.0726666666667,
          0.28301716879, 0.0752687753278, 0.220984835892, 0.00991826523224,
          0.166221364639, 0.162707364305, 0.0443572016729, 0.0375250241409
        ]
      ]
    }
  }
}
主要看”result” 里面的 “expr_prob_PXXX” 字段,3 个 qubit 对应 8 种 bitstring ,每一个 bitstring 的概率。可以算一下 P000 到 P111 对应的 8 个概率加起来是等于 1 的。
“ideal_prob_PXXX” 是理想状态下的概率。可以做一些校验、评估。可以看到同一个 bitstring ,真机测出来的概率和理想概率是有出入的。
拿到概率,后续程序就能计算泡利期望等等。到这一步真机的任务就结束了。
其他
量子计算基础
IBM 的量子计算基础教程:https://quantum.cloud.ibm.com/learning/en/courses/use-a-qc-today
写量子程序的框架
首先需要了解 Qiskit、PennyLane 这种框架,类比于深度学习中的 PyTorch/TensorFlow。这种框架封装了底层操作,让我们搭线路、求梯度、连接量子后端等等更方便。
量子计算机的优势在哪里?
一个包含 10 个 qubit 的量子态,在数学上,用多少维度的向量能表示?(等价于,N 个量子比特,有多少个基态?)想一下,是 2^10 维度向量,且这个向量的每一个元素都是复数,对应两个系数。
所以经典计算机要模拟10 个量子比特,需要存 2048 个实数,但是量子计算机只需要 10 个物理量子比特硬件。量子比特数每多一个,经典计算机要保存的参数就翻 4 倍。
50 个量子比特系统,全世界的所有硬盘加起来都装不下了。
指标
T1:量子比特从态 1 变成态 0 的时间;经过时间 t,仍然保持在态 1 的概率为:
T2:混合态的相位信息能保持多久。
相位,会间接影响概率。
所有处在混合态的量子比特,都携带相位信息。但是这个相位信息不会影响基态的概率(一个处在叠加态的量子比特相位信息发生改变是看不出来的):
比如上面的叠加态,概率取值和相位没有关系:,
但是将它施加一个量子门(幺正变换),计算基态的概率和相位有关了:
就是前面说的 Data Encoding
制备算法输入的量子初态。初始数据是向量,变成量子态才能在电路上运行。
振幅编码有硬件制备难度,不是任意向量都容易造出来。
测量
shots 采样
一个 shot 是指初始化一次量子电路、执行一次门序列,得到一个 bitstring 的过程。shot 越多,统计误差越小。
一个测量的例子:
假设我要测量的泡利串是下面这些,采样数 shots=3000
ZII, IZI, IIZ, ZZI, ZIZ, IZZ, ZZZ,
XII, IXI, IIX, XXI, XIX
一个水分子构型,对应一个输入数据,跑一次程序。
这些泡利串,有 Z 基组,X 基组。第一行加 Z 基就能全部测出,第二行加 X 基全部测出。
测上面第一行泡利串:原电路末尾直接测量(这里不用加测量的 Z 门是因为硬件的读出机制,天生就是投影到 Z 基),重复 3000 次,得到 8 种bitstring 出现的频率;
测第二行泡利串:原电路后面加 H 门,再跑电路 3000 次,得到 8 种 bitstring 出现频率,这是 X 基测量结果;
所以,1 个构型,有 2 个测量电路,每条测量电路运行 3000 次,一共 6000 次。
在本地电脑写量子代码
什么是量子后端? backend。 就是量子线路在什么设备上运行?类比经典网络,你的代码是在 CPU/GPU 运行?这就是后端。
常见的量子后端:
-
使用 Qiskit 框架,有一个本地 Aer 模拟后端;本地电脑的精确模拟器 (没有噪声、测量误差,但是可以自己加);
-
带 IBM 特性的模拟后端,获得一个真实 IBM的硬件信息,再建立模拟器;
-
真实的量子芯片;
角度编码的旋转角度是怎么交付的?每一个构型对应的角度都不一样
我们交付的电路,叫做 参数化电路模板。 它确定了门的数量、门的顺序、作用在哪一个比特。但是有一些参数(旋转角度)没有确定,只是用了参数占位。 上面的状态制备电路图,有的门角度是确定的,在电路里就被写死了。
剩下没有确定的角度,有一类是 ansatz 的可训练参数;
这部分我比较模糊,有些细节还不清楚,可以通过设计让提交电路变少,效率变高。记得有一个电路,很多组参数?
真机上参数更新过程
量子线路有 11 个可更新参数,当前 batchsize 设置为 2,一次加载 2 个构型,每个构型。
**原则:**更新 1 个参数,需要运行电路 3 次;保持当前所有参数不变,运行电路一次;该参数正移一点,运行电路;然后负移一点,运行电路,然后带入公式,计算这个参数的梯度;
误区:当前构型下,先运行 3 次电路计算梯度,更新该参数;再运行 3 次计算下一个参数的梯度;
不是的,当前构型,一次运行 23 (1+11x2)次电路,然后所有参数的梯度一次计算, 然后更新。
- 真机跑完一次拿到结果,更新 ansatz 参数之后;需要提交新的 ansatz 参数跑电路;这需要一个能访问 QPU 的经典电脑。形成一个循环。
给真机上传电路
本地计算好编码角度(特征编码这步),程序把角度和可训练的参数绑定到电路中,然后把电路编译成设备支持的门和连接方式。导出 QASM3 文件。再提交真机。
三个步骤:本地计算角度、绑定参数和角度到电路、编译提交。
量子经典混合模型怎么在真机上联合训练
因为有真机部分,也有经典部分。最终是这样的效果: 这边打包一份程序,最终在一台能访问 QPU 的电脑上 ,有这样一个训练脚本自动完成:对于每一个数据,脚本根据当前参数绑定并生成对应的量子线路,自动提交到真机,等待真机结果,然后本地电脑计算损失、量子参数的梯度(这里parameter-shift 需要额外提交参数扰动之后的 Circuit,再运行得到结果),更新量子参数。 然后脚本开始处理下一批数据,重复“绑定参数 → 提交 circuits → 获取测量结果 → 计算 loss/gradient → 更新参数”这个流程。
经典计算机和量子计算机
经典计算机怎么存储信息:晶体管和电容都是刻在硅片上的电路。用高低电平表示0,1。比如 DRAM 是电容充满电这个状态代表 1 ,反之代表 0;
超导量子计算机:量子比特也是在硅(当然也有其他)上的电路。量子计算机存储信息靠量子比特。但它存储的不是确定的0 态或者 1 态。(是叠加态),但每次读出量子比特,只会读出 0 或者 1。