笔记
大模型 2
梯度下降算法
-
是什么:目标是最小化损失函数的值,通过沿着梯度负方向更新参数。
-
公式是什么:参数更新公式
-
批量梯度下降算法是什么,具体是怎么计算的? 随机梯度下降算法、小批量梯度下降算法。
- 批量梯度下降算法的话,损失函数是有一个求和的,比如均方误差,损失函数对参数求导之后,还是有求和的,这样就能把每个样本值参与到梯度值中。
-
实战:你在训练一个图像分类模型,损失曲线如下:
前10轮损失下降很快,但之后震荡剧烈,验证精度不再提升。 你会尝试调整哪几个超参数?为什么?
-
梯度下降的局限性:保证收敛到梯度为0,不保证全局最优;对超参数敏感;只有凸函数才能保证收敛到全局最优。
-
学习率大的话,会怎样,小了呢? 大的话,每次参数更新变化比较大,可能不容易收敛;小的话,更新极其缓慢,容易卡在局部最优;
-
鞍点:多变量微分可能出现的问题。不是局部最大也不是局部最小,是梯度为0;梯度消失:梯度反向传播时,梯度越来越小,参数更新依赖梯度,梯度接近于零参数就不更新了;梯度爆炸,梯度指数级别增长,每更新一次参数,损失函数的值变得巨大。
-
对数据归一化能加速梯度收敛。 等高线是损失函数的值相等的点连成的曲线。在每一圈等高线,每次都沿着等高线垂直的方向更新,能最快指向最小值。 不归一化的话,等高曲线是椭圆,每次更新箭头左拐右拐,效率低。
反向传播算法
-
loss.backward(); 干嘛的?在多层神经网络中,计算每个参数的梯度,给梯度下降算法用。Pytorch中,计算出的梯度会存储在每个张量的
.grad属性中(需要该张量设置requires_grad=True)。 -
知道他的背后:前向传播时会构建计算图,反向传播时遍历这个计算图。
-
前向传播:是指把输入数据送入神经网络,逐层计算,得到预测值的过程。前向传播得到预测值。
-
参数更新是优化器(SGD, Adam)根据计算得到的梯度执行的:op timizer.step()
-
这样配合的
pred = model(x); 前向传播 loss = criterion(pred, y); 计算损失 optimizer.zero_grad(); loss.backward(); optimizer.step(); # 梯度会累加,如果调用十次反向传播,再调用一次优化器,那么这次更新会基于梯度的累加一次性更新; -
整体流程:前向传播(得到预测值)——计算损失——反向传播(计算梯度)——优化器更新参数
卷积
卷积是什么?为啥transformer不用卷积用点积?
- Transformer的点积能一次性计算出输入序列任意位置之间的相似度,但是卷积每一次只能看到卷积核大小的信息。如果想要看到距离较远的词的信息,必须要堆叠很多层,这样的话参数和时间复杂度都会变很高。 (卷积建模距离d的依赖,时间复杂度为O(d);
卷积适用于处理计算机视觉的任务。Transformer为自然语言处理设计,需要捕捉序列中任意两个位置之间的长距离依赖。 而卷积因为输出特征图上的每个点只依赖于输入的局部窗口。 需要很多层才能扩大视野。
卷积的计算公式?
-
卷积核在输入矩阵上移动,输入矩阵和卷积核上对应位置的元素相乘,然后所有元素再相加,得到这个位置的输出。 没有说清图片有多通道,卷积核的输出也是多通道吗; 输出通道数等于卷积核的个数,是一个超参数,由设计者指定。 卷积核的深度必须等于输入特征图的通道数。
自然语言描述:对于 RGB 图片,每一个卷积核都有 3 通道。一个卷积核在图片上移动,是这样产生输出的:对于 R 通道,卷积核在输入矩阵上移动,输入矩阵和卷积核上对应位置的元素相乘,然后所有元素再相加;因为有三个通道,所以将这三个通道的输出值相加;再加一个偏置,得到输出特征图的一个数字; 一个卷积核作用在图像上,最终输出位置上的每一个值都是这么来的。 如果有多个卷积核,每个卷积核的输出叠起来,就是多通道;
-
一个卷积核负责检测一种特征,比如边缘、纹理、颜色组合;一个卷积核扫完整张图片得到一张特征图;64个卷积核得到64张特征图,因此输出通道数是64。还需要多个卷积层,用来提取深层次的特征
卷积的时间复杂度:
假如正方形核,边长K,输入图尺寸:H1 W1 C1(高、宽、输入通道数),输出特征图的尺寸:H2 W2 C2, 卷积层时间复杂度:K^2 x C1 x H2 x W2 x C2;
-
一个卷积例子:输入224 224 3 输出 224 224 64 卷积核3 3 3;
-
输出长宽公式:
输出的长、宽由公式计算得到。 输入长度加上2倍填充P 减去 核的边长,除以 stride步长(卷积核一次移动几个像素),下取整,再加一。
卷积核的深度必须等于输入特征图的通道数C1,所以每个卷积核是一个3 3 3的张量;
卷积核的参数:
-
卷积核大小是设计者自己设置的; 卷积核的元素值不是人为指定的,是反向传播和梯度下降学习得到的;
-
import torch.nn as nn
conv = nn.Conv2d(
    in_channels=3, # 要处理图片的通道数量
    out_channels=128, # 卷积核的个数=输出通道数
    kernel_size=3, # 卷积核大小,3x3 的省略样式,可以显式指定长宽
    stride=1,# 步长
    padding=1, # 填充,影响输出的长宽
)
浅读 CNN
提到 CNN 想到的三个词:局部感受野;权值共享;pooling 层;
感受野是指某个标量的输出结果受原图多大范围的像素影响;
全连接神经网络的缺点;
resolution 分辨率:图片的长宽
卷积的归一化
三种归一化:layerNorm batchNorm groupNorm 的区别:哪些元素放在一起计算均值和方差
LayerNorm:Transformer 用,单个样本或单个 token 内,对特征维度统计
BatchNorm:同一通道,不同 token/图片,计算均值方差;跨 batch 统计
GroupNorm:一张图片经过卷积之后有很多通道,把若干通道分成一组统计,所有数字放在一起大杂烩计算
Transformer 前景知识点
Mamba
为什么出现? 长序列 自注意力复杂度;
核心思想:SSSM 推理时做了2件事,多少进入状态?历史状态保留多少?
推理时哪些参数变化,怎么变?
一维卷积做了什么? 融入相邻token信息;
状态演化方程:矩阵A决定保留多少历史信息,重要;
M和T最大区别:建模上下文的方式。显式计算、隐藏状态
并行计算:selective scan, 前缀扫描,为什么行?满足结合律
输出方程:
- mamba推理提速的核心,SSM离散化之后,就能写成RNN循环迭代的形式。只用前一时刻的状态和当前的输入,就能计算出当前状态和输出。
- mamba的并行训练:RNN是不能并行训练的,因为所有位置不能同时得到预测的token,但是mamba把离散化的SSM展开之后,写成一个矩阵乘法的形式,这样每个位置的输出就能同时得到。引入选择性机制之后又不能并行了。
解决长距离遗忘
- 传统RNN的矩阵A,是随机初始化,随着训练再调整,但是mamba使用了hippo初始化状态矩阵A;
- 此外,在推理时,RNN每一步的A矩阵完全共享,不再改变;Mamba的选择性,使A输入动态生成,每个时刻不一样。
结构Mamba结构中为什么有一个卷积层。
- 卷积擅长提取局部特征,SSM捕捉这些特征并处理长期依赖,起到一个互补的作用。
它为什么比传统SSM更会选信息?
- 传统SSM推理时,使用固定的ABC delta参数,一整个序列的遗忘和记忆完全一样,
- Mamba实现选择性SSM,每一步根据输入动态生成专属ABCdelta,能够关注重要信息。
它为什么能做长序列?
- SSM都具有的特点:通过状态递推,将历史信息保存在隐藏状态,实现线性复杂度处理长序列。
它为什么速度快?
- 和Transformer训练时一样的并行;
- 和RNN推理时一样的串行复杂度;
马尔科夫 隐马尔科夫
mamba中的卷积与CNN卷积的区别
-
最应该先记住的是二者的作用。
-
CNN卷积是 2D 空间卷积,Mamba 是 1D 序列卷积。 CNN 的计算过程,为什么说是 2D,理解为卷积核是在平面上移动的。但是每一次计算是有三个矩阵对应位置相乘的。
-
是否跨通道混合。CNN 的输出通道数等于什么?卷积核个数。
详细拆解一下 Mamba 的一维卷积计算过程。先看图片被切成 patch 之后是怎么排列的。一张图片被切成 64 个 patch,每个 patch 4x4x1(单通道),patch 展平之后每个向量是 16 维度。 这个向量的维度就是通道数。 卷积核的大小为 4。这个 卷积核大小重要理解,他是指卷积核一次覆盖的向量的个数。想象一下 64 个向量站一排,卷积核每次计算4 个向量的所有通道。 另一个需要理解的点,卷积核的形状是(kernel_size, in_channels),size 就是 4,进入通道和向量的维度是一样的16;也就是说卷积核对每一个向量作用时,卷积核有 16 个权重参数和向量的 16 个维度相乘。 但是计算输出的时候,是不同向量(本例中是 4 个)的同一个通道相加,不是同一个向量的16 个维度相加。 所以 Mamba 的卷积是没有跨通道融合的。 但是 CNN ,图片每个通道的矩形区域和卷积核每个通道的矩形区域相乘之后,最后会有三个通道加和融合的步骤。
- 那为什么 Mamba 的卷积不做通道之间的信息融合?一维卷积之前,线性投影层已经做了。 所以这里的卷积只是做相邻语义的融合。
mamba1 2 的区别:
transformer 的本质竟然是RNN。通过线性注意力机制转化。
transformer 原本平方的复杂度可以通过对偶实现线性复杂度。

Mamba2 的关键词:SSSD 结构化状态空间对偶;

Mamba1 的矩阵 A 是固定不变的;2 是可变的;
在原本的 SSM 的 A 矩阵塞入自注意力;SSM 和 注意力机制结合,达到最高效的计算性能和效果;作者起了个名字叫Mamba2
SSM 可以表示成Y=MX 的形式 M 是 ABC 的表达式; M 具有半可分结构,知道她能简化运算。

先把SSM 提升到张量收缩视角,再把注意力机制提升到张量收缩视角。发现二者是一样的;建立对偶性关联是最大的贡献;
模型混合成为趋势,整体 SSM,局部注意力机制,实现灵活组合。

细节:有一个改进是,计算注意力的 softmax 被替换成其他了操作。
整体把握一下 Mamba2:SSSD
S:structured 结构化:原始 Mamba 的 状态转移A 矩阵变成了新的具有规则的矩阵。可以用单位矩阵表示。
SS:和 Mamba 一样的状态空间递推。
D:duality 对偶.同一件事不同的视角。同一个层,既能写成选择性状态空间递推 SSM,又能写成类似 transformer 的受限注意力 SMA(结构掩码注意力)。
两个核心贡献:训练/推理提速;SSM 和 attention 统一起来;
什么是 select scan?
为了解决什么?参数依赖输入后,无法并行训练了。 他是一种并行扫描方式,把串行的递归运算重组成可并行的前缀和操作。(不理解细节)
是不是 使用并行扫描之后,把推理时候的复杂度从 N 降到了 logN ?不对。并行扫描是提升了训练时候的速度。 记住一句话:原来是串行计算隐藏层状态,需要计算 N 步;使用并行扫描之后,需要计算 logN 步,可以在 GPU 上并行了。
mamba在训练时真的是并行吗?推理时,GPU是什么并行?
Mamba 训练时为什么不像 RNN 那样完全串行?推理时又为什么可以高效?训练并行和推理并行到底是不是一回事?
推理的时候有没有并行?分情况的。在自回归生成 token 的时候,无法并行。 在 prefill 阶段,一次性算出所有隐藏状态,又是并行扫描。
硬件感知算法: 内核融合 与 重计算。
内核融合解决了 GPU 的 HBM 和 SRAM 之间巨大的读写开销导致的IO瓶颈(也就是带宽达不到)。怎么解决的:中间状态不写回 HBM。
重计算:反向传播计算梯度需要用到前向传播产生的所有中间隐状态。如果保存这些隐状态会爆显存。反向传播时候重新计算这些隐状态。这相当于拿一些计算开销换显存开销。
mamba在升维时,会不会引入无用信息?怎么处理?
会的。Mamba 升维之后的信息不全是有用的。但是会在门控、损失函数(惩罚无用信息)这些优化过程中降低无用信息的权重。所以 Mamba 不是盲目利用所有升维信息。而是在门控、选择机制中不断筛选这些信息。
Mamba 的 selective 机制到底是在“选择 token/句子”,还是在“选择信息维度”?它会不会像检索/去重一样,把相似内容删掉?Mamba 的选择性不是显式地判断“两句话语义相似,所以只保留一句”。它不是一个去重模块,也不是显式 memory selection。它的 selective 是在状态更新过程中,动态控制哪些信息写入、保留、遗忘和输出。
Vmamba结构的两个Forward是为了啥,到底有什么作用?
VMamba 中把 patch 都展开成一维向量,会不会破坏图片的二维结构?VMamba 是怎么解决的?是不是更有利于并行?
会破坏图片的二维结构。使用 SS2D 选择性扫描解决。
比如图片被切成9 个 patch。SS2D 会进行 4 次扫描。按行:每一行从左往右。每一行从右往左。按列:每一列从上到下,每一列从下到上。 每一次扫描,每一个位置都会产生一个输出,递推别忘了。在每一次扫描中,每个 patch 的位置都不一样。所以 4 次扫描同一个 patch 的输出不一样。最后把同一个位置的 4 个输出融合一下,就到了具有相邻 4 个方向位置关系的输出。
ViT
Vision Transformer 用Transformer做图像任务。核心做法:把图像切成一个个小方块patch,再把每个小方块压扁成一维向量,当成文本的token,送入encoder;
本质:抛弃 CNN 卷积,直接把图像当序列,用自注意力建模全局空间关系;
Vim/VMamba(Vision State Space Model)
mamba 不需要位置编码:为什么,状态更新方程是 因果单向时序迭代。token出现的先后顺序,已经隐藏在状态传递的路径中。
处理流程:
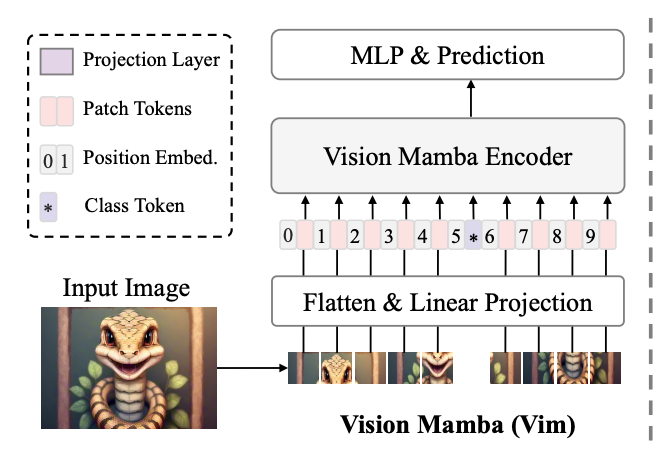
- 第一步:图像预处理:从图像到 Patch Tokens
将每个 Patch 展平,比如patch大小为16*16像素,被展开后向量的长度是:16x16x3,再通过线性投影映射为模型的嵌入维度D例如384; 得到N个形状为D的向量,每个向量代表一个图像块;ViM的输入序列长度为N;
-
第二步:添加位置与类别信息
- Position Embed,可学习的位置嵌入,与patch token逐元素相加;
- Class Token:在序列前面加一个特殊的可学习向量,在训练的过程中,会把整个图的信息浓缩进这一个向量。和ViT的思想一样。如果是分类任务才加,检测/分割任务不会加。
-
第三步:ViM Encoder,由 L 个相同的 Vim 块堆叠
-
第4步:输出层:经过 L 个 Vim 块后,序列中 class token 对应的输出向量被认为已经融合了全图的全局信息。输入一个MLP分类头,输出预测类别。
如果是检测或分割任务,则不会使用 class token,而是取所有 patch token 的输出,送入相应的任务头(如检测头、分割头)。
ViM Encoder Layer
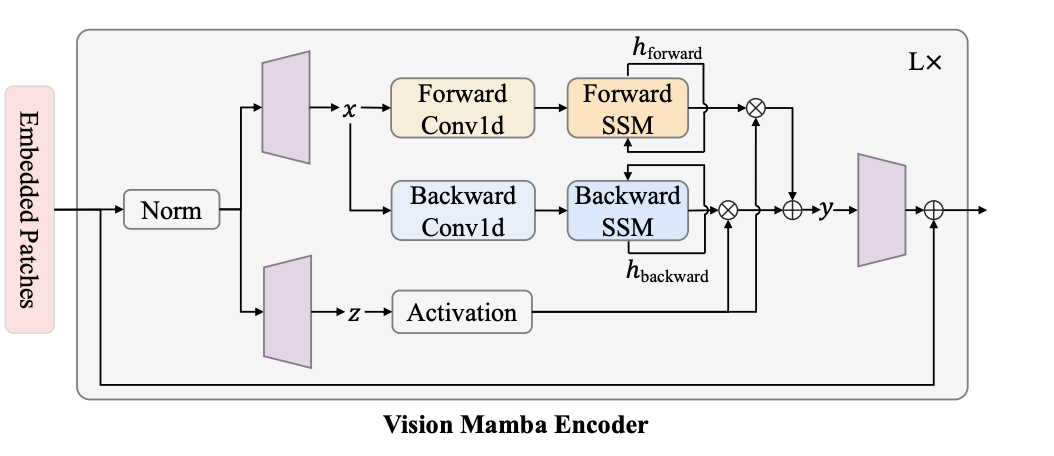
每一层内部流程:
① 层归一化
② 双向选择性 SSM 模块:分别进行前向、反向序列遍历,双向建模图像全局空间长距离依赖,融合全局视觉上下文
③ 残差连接
④ 再次层归一化
⑤ 前馈 FFN 网络完成特征非线性变换与特征重组
⑥ 再次残差连接
多层堆叠完成全局特征提取,最后输出特征用于分类、检测、分割等视觉任务。
卷积就是增强局部建模能力;相当于和SS M的长序列能力互补;
叉代表的是逐元素相乘,意思是两个维度一模一样的矩阵,对应位置的元素直接相乘?还是说是矩阵乘法?
双向输出相加;
VIM为何双向mamba?一个像素块跟前后相邻像素都有关系,正向遍历只能融合前面像素块的信息;
- 关于双向SSM:正向遍历时,当前遍历到的patch融合左上侧区域的像素信息;