笔记
模型训练、硬件
各个参数是如何影响训练时间、模型质量、资源占用
batch、training steps、epoch
batch
决定优化器每次更新模型参数用多少张图片。batch=128,每次用 128 张图片计算损失,计算梯度,更新参数。
大:显存占用高,梯度更稳定;
batch 选择的策略:每一个epoch 先把所有数据打乱,然后将数据按照 batch 大小分组,每次选一组。 这样能保证,所有图片都能被用到,每一 epoch 不会重复训练某些图片。training steps
等于优化器的优化次数=模型参数完整更新的次数。一个 step 会用一个 batch 的图片更新模型。
epoch
深度学习中,一个 epoch 表示把训练集完整遍历一轮。
比如有 N 张图片,一个 batch 是 B 张图片,那一个 epoch 需要的 batch 数量:N/B
训练、验证、测试集傻傻分不清
训练模型时,用大量的训练集更新模型参数;只有训练集的数据参与梯度更新;
模型训练结束,用验证集检验一下模型效果,看模型是否有过拟合等问题,此时根据模型出现的问题,可以可以调参: 微调的是超参数(学习率)、选择模型最佳的一轮(早停);
测试集是最终考试,用来检验模型的效果,测试集一定不能参与模型的任何参数更新;
数据格式
| 格式 | 总位数 | 指数位 | 小数位 | 特点 |
|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | 精度高、范围大 |
| FP16 | 16 | 5 | 10 | 省显存、速度快,但范围较小 |
| BF16 | 16 | 8 | 7 | 范围接近 FP32,精度低一些 |
| FP8 | 8 | 更少 | 更少 | 更省显存,但更容易有数值误差 |
BF16 范围和 FP32 差不多,不容易溢出;
FP16 精度更高,训练更快,更省显存(相比于 FP32 来说,假如模型有 10 亿参数,保存一份权重,FP32 需要 10 亿 × 4 bytes,即 (4 \times 10^9) bytes,约等于 4 GB)。
大模型训练一般用混合精度,比如 DeepSeek-V3,矩阵乘法、计算密集的地方用 FP8 更省显存;归一化、注意力矩阵等用更高精度;模型参数保存用更高精度(比如 FP32)。H100 的 Tensor Core 支持 BF16、FP16、FP8 等精度,可降低带宽占用并提高吞吐量。
部署:精度要求一般会更低。
量化
把数据从高精度表示映射成低精度表示,减少数据位数,减少缓存。可以恢复,但是有量化误差。
checkpoint
可恢复的完整状态文件。里面不止有模型权重,还有优化器状态,当前训练到第几步? 训练中断时候加载这个可以接着训练不用从头开始。
真正推理是只需要里面的模型权重文件。
显存占用
显存通常由激活决定,而不只是参数量。
激活是指前向传播(从输入计算到模型输出)的过程要保存的一些中间结果:比如注意力的 QKV,卷积层输出的特征…
显存不够
减小 batch size;
使用 BF16/FP16;
使用梯度累积;
CPU
CPU 有多个核
CPU 有多个核心,每个核心都有自己的 L1 L2 缓存,这样不必每次参数更新都访问主存。例如下表是一个 CPU 服务器的参数:
| 项目 | 实测配置 |
|---|---|
| CPU | AMD Ryzen Threadripper PRO 7975WX 32-Cores |
| 架构 | x86_64 |
| CPU 插槽 / 物理核心 / 逻辑线程 | 1 / 32 / 64;每核 2 个 SMT 线程 |
| 在线及当前进程可用 CPU | 0–63;nproc = 64,进程亲和性为 0–63 |
| NUMA | 1 个节点,node 0 包含 CPU 0–63 |
| 缓存行大小 | 64 B;sysfs 中各级缓存均为 64 B |
| L1 数据缓存 | 每核 32 KiB,共 32 个实例,总计 1 MiB |
| L1 指令缓存 | 每核 32 KiB,共 32 个实例,总计 1 MiB |
| L2 缓存 | 每核 1 MiB,共 32 个实例,总计 32 MiB |
| L3 缓存 | 每组 32 MiB,共 4 个实例,总计 128 MiB;每组由 8 个物理核心共享 |
| 内存 | 系统可见约 251.2 GiB(MemTotal: 263374732 kB) |
| 操作系统 | Ubuntu 24.04 LTS |
| 内核 | Linux 7.0.0-38-generic,x86_64 |
| CPU 调频 | CPU 0 的 governor 为 powersave; |
CPU 0–31 对应 32 个不同物理核心;CPU 32–63 是其 SMT 同胞。CPU i 与 CPU i+32 共享同一物理核心(i 为 0–31)。
下面是 CPU 缓存层次结构图:
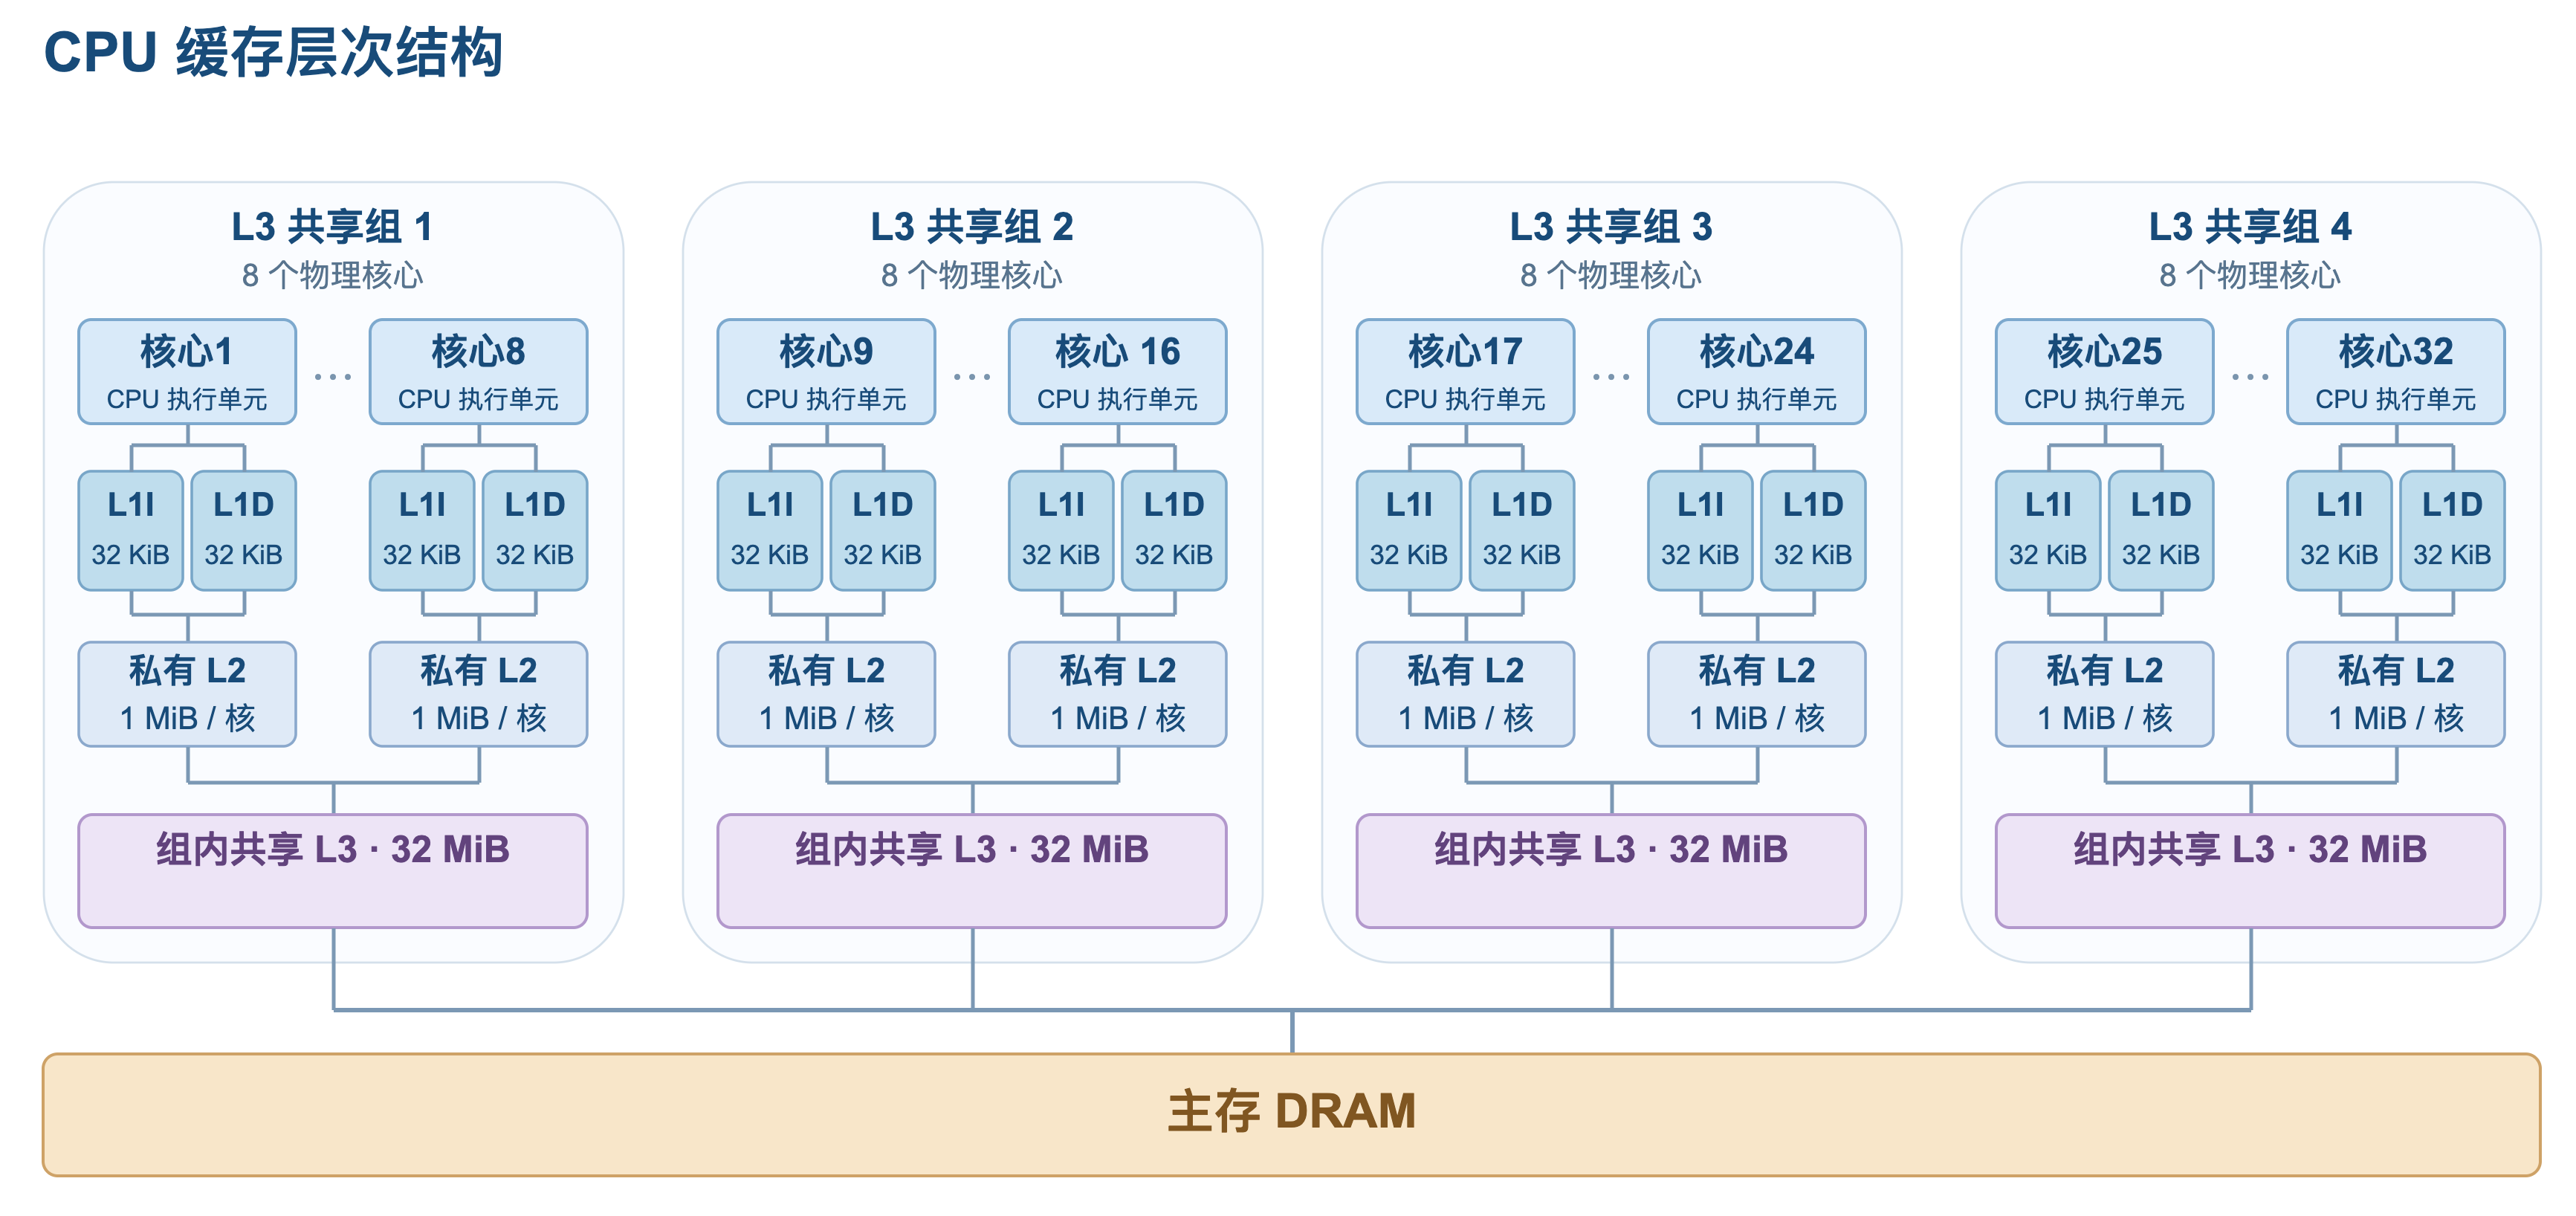
根据上图可以看到:
- 每一个核有三级 cache。cache 逐级增大;
- L1、L2 是该核自己私有的,L3 是 8 个核心共享;
- L1 分为指令 cache 和数据 cache;
大模型
8B: billion 十亿; 80 亿参数;
模型精度不同,权重占用空间也不同;
vllm:推理框架:负责加载模型、执行推理、显存管理;不用这个框架就需要,手写代码实现这些;
Qwen3-8B
官方 BF16 版本:
| 项目 | 配置 | 含义 |
|---|---|---|
| 参数量 | 约 82 亿 | 名称中的 8B 是近似值 |
| 模型类型 | 稠密、自回归语言模型 | 不是 MoE,用于逐个生成 token |
| Transformer 层数 | 36 | 网络深度 |
| 向量维度 | 4096 | 每个 token 的内部表示维度 |
| 注意力结构 | 32 个 Q 头、8 个 KV 头 | 使用 GQA(group query attention),减少 KV 缓存开销 |
| 前馈层中间维度 | 12288 | 前馈网络内部宽度 |
| 词表大小 | 151936 | 包含普通及特殊 token |
| 权重精度 | BF16(bfloat16) | 每个参数通常占 2 字节 |
参数解释:
稠密:生成一个 token 所有参数全部参与运算;不像 MoE 只激活部分参数;
自回归:生成 token 是一个一个生成,不是一下生成一行;
结构只有 Decoder。
-
36 层 Transformer :其中每一层的结构:
1输入向量先归一化
2进入注意力部分,然后再归一化;
3前馈神经网络部分:4096-12288-4096,不要忘了激活函数;
4 再归一化;
-
向量经过所有的 transformer 层之后。会乘以一个具体的超大矩阵:4096x151936 生成一个151936 维度的向量,向量的每一维度上对应的数字是对应词的概率(也可能是评分)