项目
PyCG论文复现
参考老师的评分标准,让 AI 筛选好复现的论文,结果过度追求容易复现,在复现难度、工作量上面不够。大部分时间在理解论文的流程上,在 AI 的帮助下复现是比较容易的。
本身的方向和程序分析不一样,就当是锻炼 presentation 的能力了。了解了 Pyhton 动态特性(运行时产能确定变量类型)、语法抽象树是 Python 解释器把 Python 源码到执行程序的一个中间产物。其他倒是想不出学到了什么。
仓库地址:https://github.com/zhanghao0806/PyCG-reproduction
论文链接:https://arxiv.org/html/2103.00587
基础知识
论文工作
这篇论文干什么的?
提出了一种新的方法,生成 Python 程序的调用图。
调用图:节点是函数,边表示谁可能调用谁;
重要条件是:在纯静态环境下(只看源码),把调用图画出来。
-
为什么不通过动态方法(运行代码)分析?
1 运行程序有代价;
2 而且覆盖不到所有的分支语句。所以静态条件下画调用图很有难度。更难的是 Python 是动态语言(不像 C++ Java 变量类型已经写死)。
Python AST
-
Abstract Syntax Tree 抽象语法树;
Python 代码执行前会被 Python 解释器 翻译成一系列中间产物,AST 是其中的一种。
-
AST 有很多节点,节点算是 Python 对象吧,有很多字段。
常见节点:FunctionDef(对应源码中的 def)、 Call (对应函数调用)、Assign(赋值语句);
-
重要的函数 parse(),dump();
Python的 dump() 很多类都有:大体作用都是把内存中的某种数据“输出”,便于查看、保存。
import  ast
code = "x = 1 + 2"
tree = ast.parse(code)
print(ast.dump(tree, indent=2))

'''
Module(
  body=[
    Assign(
      targets=[
        Name(id='x', ctx=Store())],
      value=BinOp(
        left=Constant(value=1),
        op=Add(),
        right=Constant(value=2)))],
  type_ignores=[])
'''
Pyhton 作用域机制
LEGB 原则;
函数是一等对象,可以赋值给变量,可以作为函数参数、可以作为函数返回值;但是注意不要带括号,只要函数名就行了;
def test(func, arg):
    func(arg)
    func(arg)
test(print, "hello world")
'''
hello world
hello world
'''
论文给出了 python 语言特性带来的挑战:现有静态方法没法解决这些问题。又举了现有两个开源静态分析器生成函数调用图的例子,显示他们的效果很差。
关键设计:按照命名空间区分属性访问。
使用的方法
通过带上命名空间区分相同名字的字段;
图三:设计自己的语法结构,表示程序源码,相当于简化版的 AST;
论文如何将一个 Python 程序变成可分析的结构?Pipeline 是什么?
笼统两步:先得到赋值图,再得到调用图。
Pipeline
1 源码变成中间表示:
先把 python 代码变成解析成 AST;
但是 AST 还不够简洁,于是论文自定义了一种中间表示;
2 维护 4 个核心状态域(数据结构):
得到中间表示之后,维护一些数据结构:作用域树、当前命名空间、赋值图;
作用域树,表示 谁 定义在 谁里面;
3 不动点迭代分析(核心计算):
作者定义了状态转移规则:不断更新第二步的四个核心状态域直到收敛;
收敛:反复运用论文图六的状态转移规则,往作用域树、赋值图等添加新边,直到没有一条新边可以加。
最难理解的地方;
4 生成调用图:
第三步稳定后,生成了赋值图;这一步重新遍历中间表示,在赋值图的帮助下得到调用图。
论文定义一个算法流程。
调用图生成流程
总体来说单单复现的话比较简单,有 GPT 帮忙。关键是搞懂论文吧。
样例源码
接下来以一个代表用例,详细介绍作者的程序是怎么生成调用图的。
关键:这个样例展示了:函数可以赋值给变量,函数还能作为形参传递,这些关系必须被追踪到。
parameters/nested_call:
def nested_func():
    pass

def param_func(a):
    a()

def func(a):
    a(nested_func)

b = param_func
c = func
c(b)-
重要区别:第八行,a(nested_func) 和 a(nested_func())。前者传进去的是函数本身,后者是先执行函数,然后传进去的是返回值。
人写的话,这个调用图很简单。
第一步:
读取 main.py,用 ast.parse() 转成抽象语法树,再查看和保存它。
from pathlib import Path
import ast

source_path = Path(
    "../"
    "reference/paper_artifact/data/micro-benchmark/"
    "parameters/nested_call/main.py"
)
source_code = source_path.read_text(encoding="utf-8")
# 带行号显示源码,方便后面对照 AST
for line_number, line in enumerate(source_code.splitlines(), start=1):
    print(f"{line_number:2}: {line}")
此时得到包含源码的字符串,接下来生成 AST
tree = ast.parse(
    source_code,
    filename=str(source_path),
    mode="exec",
)
print(type(tree))
ast_text = ast.dump(
    tree,
    indent=4,
    include_attributes=False,
)
print(ast_text)
输出:
<class 'ast.Module'>
Module(
    body=[
        FunctionDef(
            name='nested_func',
            args=arguments(
                posonlyargs=[],
                args=[],
                kwonlyargs=[],
                kw_defaults=[],
                defaults=[]),
            body=[
                Pass()],
            decorator_list=[]),
        FunctionDef(
            name='param_func',
            args=arguments(
                posonlyargs=[],
                args=[
                    arg(arg='a')],
                kwonlyargs=[],
                kw_defaults=[],
                defaults=[]),
            body=[
                Expr(
                    value=Call(
                        func=Name(id='a', ctx=Load()),
                        args=[],
                        keywords=[]))],
            decorator_list=[]),
        FunctionDef(
            name='func',
            args=arguments(
                posonlyargs=[],
                args=[
                    arg(arg='a')],
                kwonlyargs=[],
                kw_defaults=[],
                defaults=[]),
            body=[
                Expr(
                    value=Call(
                        func=Name(id='a', ctx=Load()),
                        args=[
                            Name(id='nested_func', ctx=Load())],
                        keywords=[]))],
            decorator_list=[]),
        Assign(
            targets=[
                Name(id='b', ctx=Store())],
            value=Name(id='param_func', ctx=Load())),
        Assign(
            targets=[
                Name(id='c', ctx=Store())],
            value=Name(id='func', ctx=Load())),
        Expr(
            value=Call(
                func=Name(id='c', ctx=Load()),
                args=[
                    Name(id='b', ctx=Load())],
                keywords=[]))],
    type_ignores=[])
根据输出结果可以看到:有三种节点类型:函数、赋值语句、表达式语句;
从最后面的表达式语句,AST 只能看出c的参数是 b,不知道 c 指向哪个函数、b 指向哪个函数,甚至不一定知道 b 是函数。
第二步:
调用作者的PreProcessor,将 AST 变成作者的中间表示;
import json

from pycg.pycg import CallGraphGenerator
from pycg.processing.preprocessor import PreProcessor
from pycg.utils.constants import CALL_GRAPH_OP, NAME_DEF

# 使用前面已经定义的 source_path
source_path = source_path.resolve()

# 创建分析器及其内部的数据管理对象
analyzer = CallGraphGenerator(
    entry_points=[str(source_path)],
    package=str(source_path.parent),
    max_iter=-1,
    operation=CALL_GRAPH_OP,
)

# 只运行预处理这一遍
try:
    analyzer.do_pass(
        PreProcessor,
        True,
        analyzer.import_manager,
        analyzer.scope_manager,
        analyzer.def_manager,
        analyzer.class_manager,
        analyzer.module_manager,
    )
finally:
    analyzer.remove_import_hooks()
运行完预处理,把数据打印出来看一下:
definitions = {}

for name, definition in analyzer.def_manager.get_defs().items():
    pointer = definition.get_name_pointer()

    definitions[name] = {
        "type": definition.get_type(),
        "points_to": sorted(pointer.get()),
        "arguments": {
            key: sorted(values)
            for key, values in pointer.get_args().items()
        },
    }

print(json.dumps(definitions, indent=2, ensure_ascii=False))
输出:
{
  "main": {
    "type": "MODULEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.nested_func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {
      "a": [
        "main.param_func.a"
      ]
    }
  },
  "main.func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {
      "a": [
        "main.func.a"
      ]
    }
  },
  "main.nested_func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func.a": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.func.a": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {
      "0": [
        "main.nested_func"
      ]
    }
  },
  "main.b": {
    "type": "NAMEDEF",
    "points_to": [
      "main.param_func"
    ],
    "arguments": {}
  },
  "main.c": {
    "type": "NAMEDEF",
    "points_to": [
      "main.func"
    ],
    "arguments": {
      "0": [
        "main.b"
      ]
    }
  }
}
输出结果大概对应作者定义的中间表示。
“points_to”: [] 含义:这个名字可能指向的对象合集;
“main.b” 的 points_to": ["main.param_func"], 说明程序已经识别出 b 代表的是函数 parm_func;
还有一个值得关注的:main.param_func 和 main.func 都有形参 a,但是他们命名空间不同。这是论文重要的设计之一:按标识符所在的命名空间区分对象;
第三步:
传播关系直到收敛。
from pycg.processing.postprocessor import PostProcessor

# 先补全预处理阶段记录的参数关系
analyzer.def_manager.complete_definitions()

# 重复分析,直到状态不再变化
while not analyzer.has_converged():
    analyzer.state = analyzer.extract_state()
    analyzer.reset_counters()

    analyzer.do_pass(
        PostProcessor,
        False,
        analyzer.import_manager,
        analyzer.scope_manager,
        analyzer.def_manager,
        analyzer.class_manager,
        analyzer.module_manager,
    )

    analyzer.def_manager.complete_definitions()

# 重新读取收敛后的信息,更新之前的 definitions
definitions = {}

for name, definition in analyzer.def_manager.get_defs().items():
    pointer = definition.get_name_pointer()
    definitions[name] = {
        "type": definition.get_type(),
        "points_to": sorted(pointer.get()),
        "arguments": {
            key: sorted(values)
            for key, values in pointer.get_args().items()
        },
    }

print("是否收敛:", analyzer.has_converged())
print(json.dumps(definitions, indent=2, ensure_ascii=False))
输出:
是否收敛: True
{
  "main": {
    "type": "MODULEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.nested_func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {
      "a": [
        "main.param_func.a"
      ]
    }
  },
  "main.func": {
    "type": "FUNCTIONDEF",
    "points_to": [],
    "arguments": {
      "a": [
        "main.func.a"
      ]
    }
  },
  "main.nested_func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.param_func.a": {
    "type": "NAMEDEF",
    "points_to": [
      "main.nested_func"
    ],
    "arguments": {}
  },
  "main.func.<RETURN>": {
    "type": "NAMEDEF",
    "points_to": [],
    "arguments": {}
  },
  "main.func.a": {
    "type": "NAMEDEF",
    "points_to": [
      "main.b"
    ],
    "arguments": {
      "0": [
        "main.nested_func"
      ]
    }
  },
  "main.b": {
    "type": "NAMEDEF",
    "points_to": [
      "main.param_func"
    ],
    "arguments": {
      "0": [
        "main.nested_func"
      ]
    }
  },
  "main.c": {
    "type": "NAMEDEF",
    "points_to": [
      "main.func"
    ],
    "arguments": {
      "0": [
        "main.b"
      ]
    }
  }
}
此时所有关系已经收敛,可以看到和第一步的输出不同的地方有:
main.func.a 的 points_to从空变成了 "main.b",说明程序已经识别出 func()的参数 a 其实是变量 b;
main.param_func.a 的 points_to从空变成了 "main.nested_func";说明程序识别出 函数 param_func 里面的 a 是函数nested_func;
第四步:
根据已收敛的状态(保存在 analyzer中),生成调用图。
from pycg.formats.simple import Simple
from pycg.processing.cgprocessor import CallGraphProcessor

analyzer.reset_counters()

analyzer.do_pass(
    CallGraphProcessor,
    False,
    analyzer.import_manager,
    analyzer.scope_manager,
    analyzer.def_manager,
    analyzer.class_manager,
    analyzer.module_manager,
    call_graph=analyzer.cg,
)

callgraph = Simple(analyzer).generate()

print(json.dumps(callgraph, indent=2, ensure_ascii=False))
输出:
{
  "main": [
    "main.func"
  ],
  "main.nested_func": [],
  "main.param_func": [
    "main.nested_func"
  ],
  "main.func": [
    "main.param_func"
  ]
}
得到这样的键值对。键表示函数名,对应的列表是他直接调用的函数; 把得到的输出,可视化成一张图:
import networkx as nx
import matplotlib.pyplot as plt

g = nx.DiGraph(callgraph)
pos = {name: (i, 0) for i, name in enumerate(nx.topological_sort(g))}

plt.figure(figsize=(10, 2))
nx.draw(
    g, pos, with_labels=True,
    node_size=0,
    font_size=10,
    arrowsize=20,
    min_source_margin=65,
    min_target_margin=65,
)
plt.show()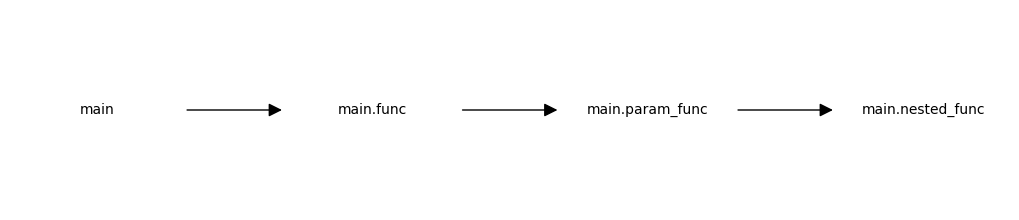
为什么论文中提到的方法不行
接下来用论文中提到的 Pyan 方法,对同样一个测试用例生成调用图,看结果是否不行;
程序
from pathlib import Path
import json
import subprocess
import sys

source_path = Path("../reference/paper_artifact/data/micro-benchmark/parameters/nested_call/main.py").resolve()
pyan_path = Path("../reference/paper_tools/pyan/pyan.py").resolve()

print(source_path.read_text(encoding="utf-8"))
输出:
def nested_func():
    pass

def param_func(a):
    a()

def func(a):
    a(nested_func)

b = param_func
c = func
c(b)
运行论文工件中的 Pyan,结果保存在内存中并直接显示。
result = subprocess.run(
    [sys.executable, "-B", str(pyan_path), str(source_path)],
    capture_output=True,
    text=True,
    check=True,
)
callgraph = json.loads(result.stdout)
print(json.dumps(callgraph, indent=2, ensure_ascii=False))
输出:
{
  "main": [
    "main.func",
    "main.param_func"
  ],
  "main.func": [
    "main.nested_func"
  ],
  "main.nested_func": [],
  "main.param_func": []
}
画出 Pyan 实际输出的关系。
import networkx as nx
import matplotlib.pyplot as plt

g = nx.DiGraph(callgraph)
pos = {}
for level, nodes in enumerate(nx.topological_generations(g)):
    nodes = sorted(nodes)
    for i, name in enumerate(nodes):
        pos[name] = (i - (len(nodes) - 1) / 2, -level)

plt.figure(figsize=(7, 4))
nx.draw(g, pos, with_labels=True, node_size=0, font_size=10,
        arrowsize=18, min_source_margin=22, min_target_margin=22)
plt.show()
实测结果:
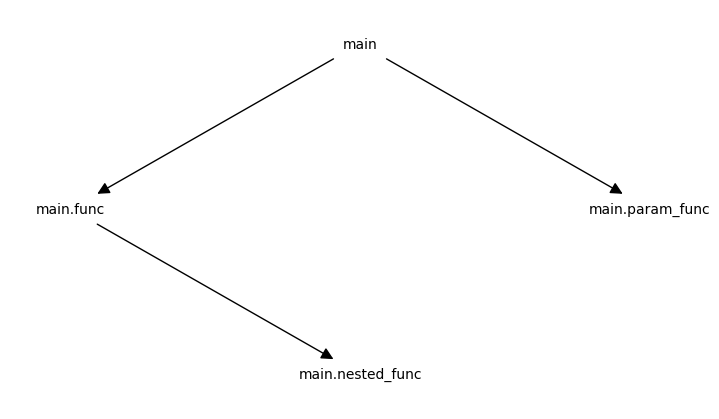
Pyan 漏掉 main.func 调用 main.param_func、main.param_func 调用 main.nested_func 两条边;多出 main 使用 main.param_func、main.func 使用 main.nested_func 两条边。
为什么会漏边:
Pyan 能看到代码中调用了 a,但没有把跨函数传递的实参与形参关联起来,不知道形参 a 其实是param_func;
复现过程
整体复现内容
| 微基准:112 个最小 Python 程序 | 真实项目基准:5 个开源 Python 项目 | |
|---|---|---|
| 特点 | 每个程序聚焦一种调用场景,规模小、便于定位错误 | 包含多个模块、函数和类,调用关系更复杂 |
| 内容 | 函数赋值、参数传递、返回值、闭包、继承、模块导入等,共 16 类 | autojump、fabric、asciinema、face_classification、Sublist3r |
| 评价 | 检查是否存在多余调用边或遗漏调用边 | 计算精确率和召回率 |
112个小型测试用例
第一次运行,复现论文中提到的 112 个程序对应的调用图,复现结果和论文中提到的一致。
| 指标 | 论文结果 | 本次结果 |
|---|---|---|
| Complete 检查:没有多余调用边 | 111/112 | 111/112 |
| Sound 检查:没有漏掉应有调用边 | 103/112 | 103/112 |
PyCG 的局限性:
不支持 * 号解包
assignments/starred
def func1():
    pass
def func2():
    pass
def func3():
    pass
def func4():
    pass
a, *b, c = func1, func2, func3, func4
a()
b[0]()
b[1]()
c()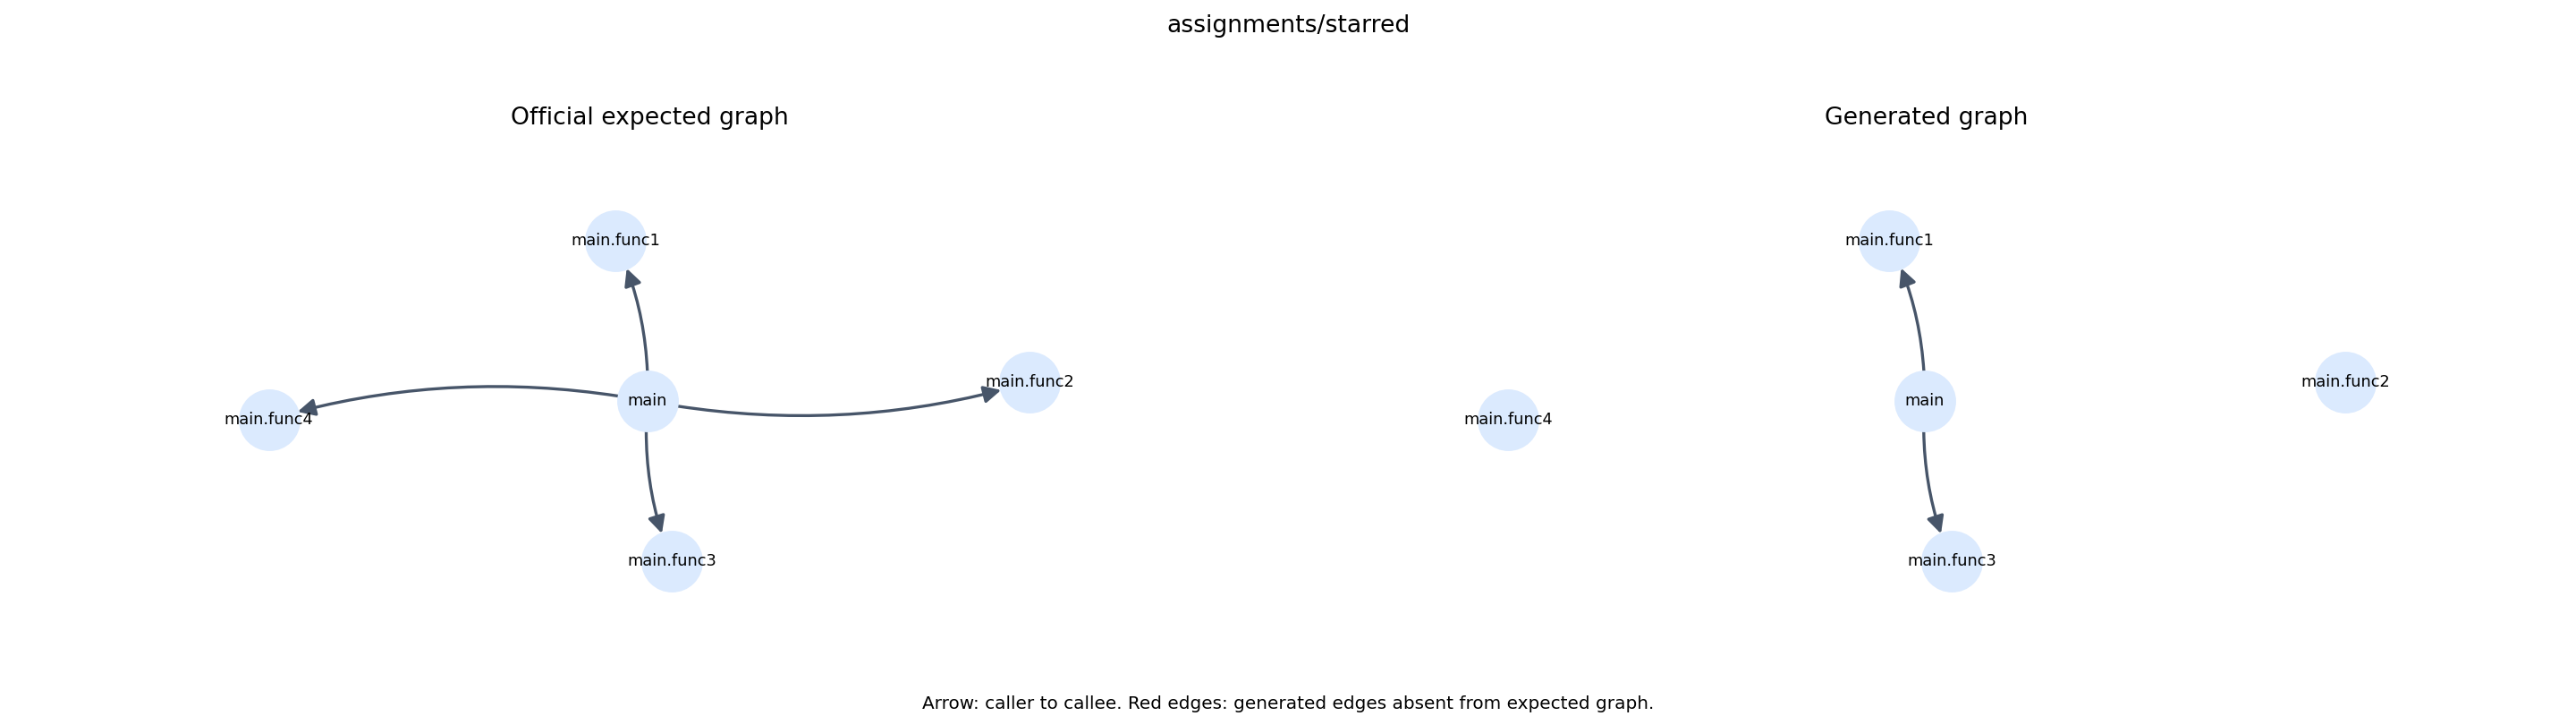
不支持处理星号解包的“中间收集、尾部匹配”规则,导致函数绑定错误并遗漏调用边;
不支持内置对象的方法
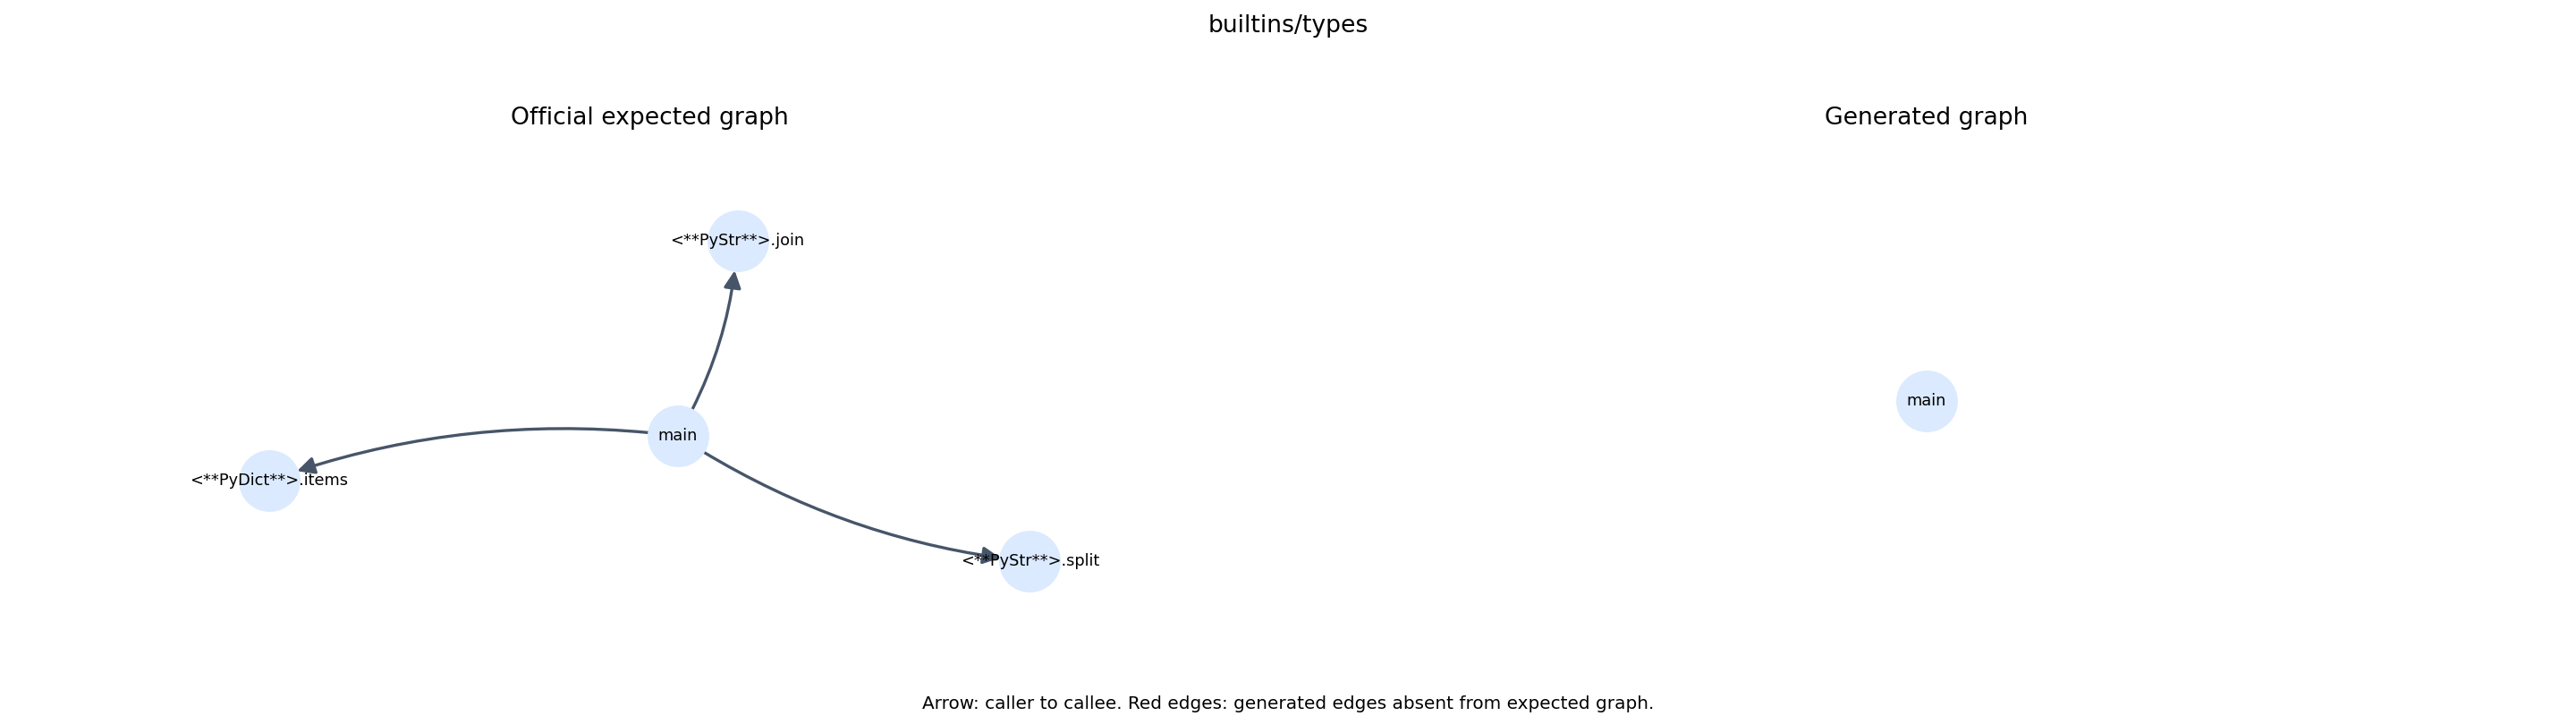
builtins/types
" ".join(["1", "2", "3"])
# 按空格拼接:"1 2 3"
"a b c".split(" ")
# 按空格拆分: ["a", "b", "c"]
d = {"a": 1}
d.items()
# 可视化键值对
一共调用了三个函数,PyCG无法识别:不包含任何调用包。
5个大型项目
先大致介绍项目的情况;
| 项目 | 功能 | 论文报告代码行数 |
|---|---|---|
| autojump | 命令行目录跳转 | 2,662 |
| fabric | 远程执行与部署 | 3,236 |
| asciinema | 终端录屏 | 1,409 |
| face_classification | 人脸相关分类 | 1,455 |
| Sublist3r | 子域名枚举 | 1,269 |
| 项目 | 本次精确率 | 作者精确率 | 本次召回率 | 作者召回率 |
|---|---|---|---|---|
| autojump | 99.5% | 99.5% | 68.2% | 68.2% |
| fabric | 98.3% | 98.3% | 61.9% | 61.9% |
| asciinema | 100.0% | 100.0% | 68.3% | 68.3% |
| face_classification | 99.5% | 99.5% | 89.7% | 89.7% |
| Sublist3r | 98.8% | 98.8% | 61.6% | 61.6% |
| 平均 | 99.2% | 99.2% | 69.9% | 69.9% |
| 分析器与环境 | 112 个小用例 | 5 个真实项目 |
|---|---|---|
| 0.0.2 + Python 3.10,未经兼容处理 | 未对齐 | 指标全部对齐 |
| 0.0.8 + Python 3.10 | 对齐 | 未对齐 |
| 0.0.2 + Python 3.10,仅临时修正下标解析 | 全部分类指标对齐 | 全部分类指标对齐 |
评价指标:
精确率:分析器生成的边,有多少是正确的?
召回率:真实的边,分析器找到了多少?
把文件实验包可以整理一下了;